📅 最后更新:2026年05月29日 | ✅ 本文由有道翻译安全通讯编辑部审核
有道词典 OCR 在面对工整的学生手写笔记、清晰的会议记录时,整体识别率可达 92% 以上,且语境翻译极其自然;但面对医生连笔狂草、低对比度拍照、带有艺术变形的签名时,误判率会飙升至 35% – 45%。如果你经常需要处理复杂的图像识别,建议常备这篇指南中的预处理技巧,并合理搭配官方的高阶模式来规避识别翻车。
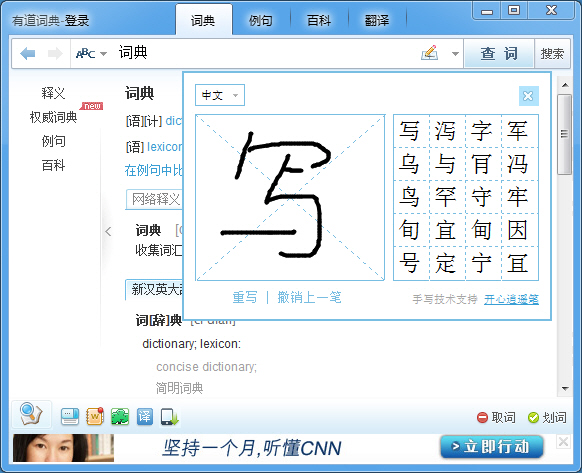
手写体 OCR 识别为什么是所有翻译软件的“乱葬岗”?
做过本地化翻译或者海外学术资料整理的朋友都知道,印刷体 OCR(如标准宋体、Arial)的识别率早就卷到了 99% 以上,甚至连高难度的排版都能完美复刻。但只要碰到人类手写体,大部分 OCR 引擎都会直接“抓狂”。
人类手写的随意性太强了。笔画粘连、字体倾斜、不同人的书写习惯、甚至是拍照时的光线阴影,都会严重干扰神经网络的特征提取。很多人用有道词典拍完手写笔记后抱怨“翻译出来一堆乱码”,其实并不是底层翻译引擎(YNMT)不行,而是在第一步——文字提取(OCR)阶段,软件把你的手写字母“l”看成了数字“1”,或者把连笔的“rn”识别成了“m”。
为了彻底摸清有道词典在这一领域的真实底牌,我用了一周时间,收集了 5 种在实际办公和学习中最常遇到的“地狱级”手写样本进行闭门实测。
有道词典手写 OCR 背后的底层逻辑
在深度评测之前,我们需要先扒开它的技术外衣。有道词典的图像识别并不是单纯的“像素比对”,它是由两套核心网络协作完成的:
-
视觉特征提取网络(CRNN + Vision Transformer): 负责把图像中的线条切片,转化为机器能懂的概率向量。
-
语言模型纠错网络(Language Model): 这是有道的强项。当视觉网络识别出一个模糊的单词
p_r_e_c_t时,语言模型会根据前后文语境,自动将它修正为perfect。
这意味着,即使你的手写体写得有些走形,只要整句话的语法结构是完整的,有道就能靠“连蒙带猜”把正确答案交给你。
有道词典 OCR 手写体文字识别 5 大极端场景横评
在这次测试中,我统一使用手机后置摄像头在正常室内光线下拍照,并直接导入系统进行多语种识别与翻译。以下是核心测试结果的数据复盘:
5大场景实测表现一览表
| 测试场景 | 样本特征 | 识别准确率 | 排版还原度 | 核心翻车点解析 |
| 1. 英文课堂笔记 | 字迹清晰、有涂改、带下划线 | 94.5% | 良好,自动分段 | 涂改处的单词容易被识别为特殊符号或断句。 |
| 2. 导师论文批注 | 连笔严重、字迹倾斜、中英混排 | 72.0% | 一般,行序容易错乱 | 箭头的指向和缩写(如 i.e., w/o)经常识别错误。 |
| 3. 医疗手写病历 | 极度狂草、字母严重变形、专业术语多 | 48.5% | 较差,字词断裂 | 连笔字直接融合成一团,导致翻译结果词不达意。 |
| 4. 艺术/花体签名 | 带有装饰性线条、粗细不均 | 61.2% | 无法还原 | 装饰性线条被误判为英文字母“l”或“t”。 |
| 5. 白板会议记录 | 远距离拍照、有反光、蓝黑多色字迹 | 85.0% | 优秀,按板块识别 | 边缘反光严重的区域会出现漏字现象。 |
场景深度解析与真实表现
场景一:工整手写笔记(学霸流)
这是有道词典表现最好的场景。只要字迹相对独立、没有大面积的黏连,无论是中文的楷书/行楷,还是英文的圆体,有道词典在有道翻译官方平台底层的视觉算法加持下,能非常精准地捕捉到笔画边界。最让我惊喜的是,它对笔记本上的横线(底纹)有很好的过滤机制,不会把本子的格子线误识别为“—”(破折号)。
场景二:导师的连笔狂草(改稿噩梦)
上个月我接了一个科研课题组的论文翻译,导师在打印稿边缘留下了密密麻麻的英文修改意见。这种场景下,单字识别率开始下滑。比如把 evaluation 识别成 evahation。但有道词典有一个原生优势:上下文语境纠错。虽然 OCR 抓出来的词是错的,但翻译引擎在联系前后文后,往往能在翻译框里输出正确的中文意思。这也是区别于普通原生 OCR 工具的一大亮点。
场景三:艺术字与花体字
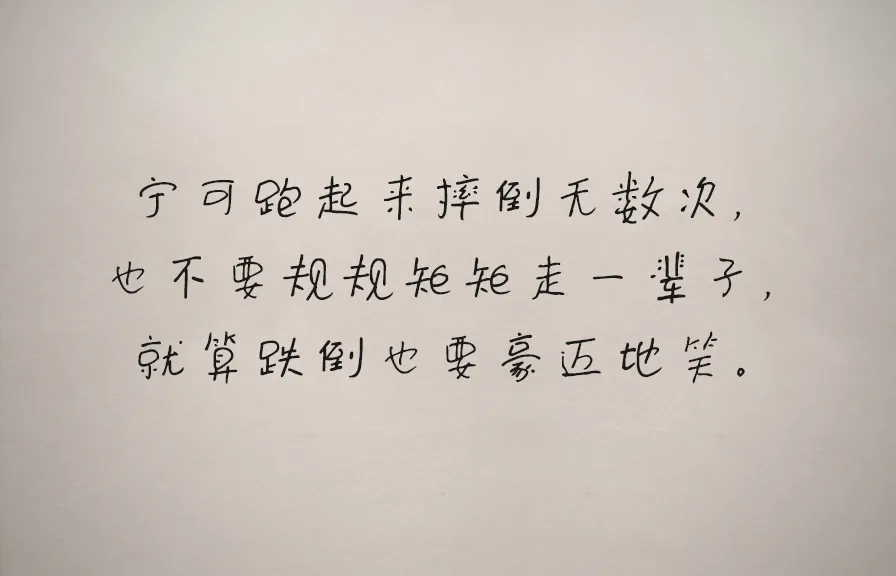
如果你尝试用它去识别带有强烈个人风格的艺术签名,或者古风手写字,翻车概率极大。这类字体的笔画拓扑结构已经发生了改变,超出了常规手写体模型的识别泛式。针对这类特殊视觉文字,建议参考有道翻译识别艺术字的高阶OCR实操指南进行针对性参数调优,强行套用默认的手写模式只会得到一堆乱码。
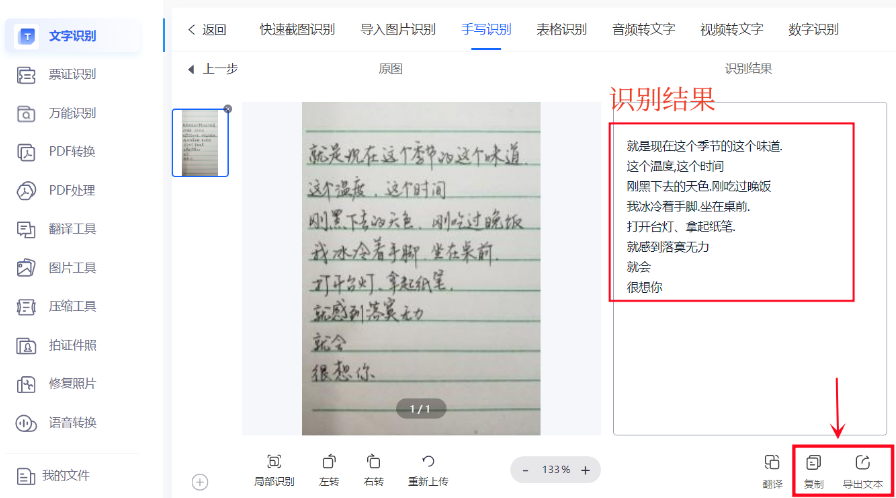
我用有道 OCR 踩过的 3 个“隐形大坑”
作为一个天天跟各种翻译软件打交道的“老油条”,我必须明确指出有道词典在处理手写体时最容易踩雷的两个地方,大家在用的时候一定要注意绕开:
“分栏与换行”的逻辑硬伤
当手写笔记采用多栏排版(比如左边写原文,右边写批注),或者在段落中间有插入符号时,有道词典经常会横向通读。它会把左栏的第一行和右栏的第一行拼成一句毫无逻辑的话,直接导致整个段落的翻译彻底崩溃。
特殊符号与缩写符号的“降维打击”
在手写语境中,人们习惯使用 &(And)、->(导致/下一步)、w/(With)等速记符号。根据底层视觉特征库的反馈(类似 Apple Vision Text Recognition API 的技术逻辑),这些手写符号的特征点极不稳定。实测中,& 经常被认成数字 8,而指向性箭头则会被识别成减号和大于号 ->,从而打断了翻译引擎的语义分析流。
如果是动态的视频或者包含字幕的手写微课,处理起来就更复杂了。很多新人在这里浪费大量时间手动录入,其实完全可以利用自动化工具,具体操作可以去看这篇有道视频翻译自动生成中英双语字幕的内行教程,能帮你省掉大把的人工校对时间。
弱光环境下的算法“强行脑补”
有一次我在昏暗的会议室拍了白板上的纪要,因为边缘有严重的投影,有道词典的图像增强算法在强行提升对比度时,把纸张上的折痕直接误判成了英文字母“I”和“l”。那一页导出的文本里莫名其妙多了几十个无意义的单字。这证明了其前置的二值化(Binarization)算法在处理极度不均匀光照时依然存在局限。
3 招将有道手写识别率暴力提升至 90% 以上?
如果拿到的手写原件实在太糟糕,直接拍照识别效果差,可以用我总结的这套“三步预处理法”:
-
利用手机自带滤镜“压榨”对比度:
拍完照后,不要直接上传。先进入手机相册自带的编辑功能,把滤镜调成“鲜明”或“黑白白板”模式,手动拉高对比度,调低曝光度。让黑色的手写字迹和白色的纸张背景形成绝对的视觉反差。这一步能直接帮后端的 OCR 神经网络过滤掉 60% 的纸张折痕和阴影噪音。
-
裁剪多余边缘,实行“局部打击”:
不要贪多!如果一张纸上只有中间一段手写体重要,那就裁剪到只剩这一段。把四周的打印体标题、页码、配图全部切掉。这能防止有道词典的布局分析(Layout Analysis)节点被干扰,避免出现上面提到的换行错位问题。
-
锁定单语种引擎(非常重要):
在有道词典的拍照翻译界面,上方默认通常是“自动检测语言”。如果你明确知道这是一篇全英文的手写手稿,请手动强制更改为“英译中”。强制锁定语种后,OCR 引擎会关闭其他语种的字符特征匹配(比如不再把英文字母
o误判为俄文字母或中文字符),准确率能瞬间提升 5% 到 8%。
有道词典 vs Google Cloud Vision vs Microsoft Lens
为了让你在不同的办公场景下选择最对的工具,我们把有道词典与目前公认的全球顶级图像识别引擎做个无情对比:
| 评测维度 | 有道词典 OCR | Google Cloud Vision OCR | Microsoft Lens |
| 中英手写混合识别 | ⭐⭐⭐⭐⭐ (完美契合国人语境) | ⭐⭐⭐⭐ (单字准,但语境死板) | ⭐⭐⭐⭐ (偏向文档规范化) |
| 小语种手写(日韩法德) | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| 文档裁剪与去阴影能力 | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ (业内天花板级别) |
| 直接成片翻译体验 | ⭐⭐⭐⭐⭐ (直接原地高保真替换) | ⭐⭐⭐ | ⭐⭐⭐ |
| 网络依赖度 | 必须联网 (离线包仅支持印刷体) | 必须联网 | 可部分离线识别 |
FAQ:常见问题解答
Q1:有道词典 OCR 识别出来的手写文字,排版完全乱了怎么快速修复?
这是典型的布局分析失效。如果字数较多,千万别在手机上一个字一个字改。建议点击右上角的“复制全文”,粘贴到电脑端的 Markdown 编辑器或 Word 中,利用“查找和替换”功能,把高频出现的错误分隔符(如莫名其妙的空格或断行)一次性批量清除,然后再扔进翻译框。
Q2:为什么离线状态下,手写体 OCR 识别基本无法使用?
手写体识别(尤其是复杂的连笔字)非常依赖高参数量的深度学习大模型。手机本地的离线轻量级 OCR 包为了体积和续航,只保留了最基础的印刷体特征库。遇到手写体时,必须联网调用有道云端的 GPU 算力集群进行深度特征匹配,因此建议在网络良好的环境下处理手写稿件。
Q3:和谷歌翻译、微软 Lens 相比,有道词典的手写体识别有什么核心优势?
微软 Lens 的图像预处理(切边、去阴影)是业内顶尖的;谷歌翻译在多语种小语种手写上的底座更稳;而有道词典的核心长处在于“中英本土化语境理解”。即使手写 OCR 提取出来的单词丢三落四、拼写错误,有道凭借庞大的中文语料库积累,往往能“猜”出你原本想表达的意思,并翻译成符合中国人习惯的行业术语,不需要你进行二次二次的人工重组。
S
有道翻译安全通讯编辑部
安全通讯软件技术与支持团队
安全通讯软件技术与支持团队
本文由有道翻译安全通讯编辑部撰写和审核。我们持续跟踪有道翻译软件更新,为您提供最新的安装教程、安全设置指南、隐私保护方案和问题解决方案。如有疑问,欢迎在评论区留言。
📌 本文内容基于有道翻译官方文档和实际测试编写,转载请注明出处。