📅 最后更新:2026年05月26日 | ✅ 本文由有道翻译安全通讯编辑部审核
有道视频翻译自动生成中英双语字幕的核心流程只有三步:上传原视频、配置语音识别(ASR)与机器翻译(NMT)参数、在AI工作台中完成微调并一键双语导出。要想字幕不发生时间轴漂移或语序错乱,切记在上传前完成音频降噪,并提前挂载自定义术语库(Glossary)。如果原视频含有高密度背景音乐(BGM),务必手动调整声音活动检测(VAD)阈值以防断句碎裂。
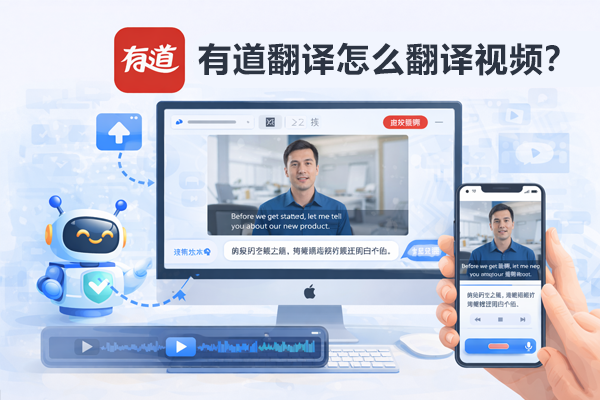
跨海搬运与出海标配:为什么单靠人工做双语字幕会让你破产?
我们团队承接了一个跨境电商出海项目,需要把50个高密度的全英文海外评测视频本土化成中英双语字幕。一开始,新来的运营实习生打算用传统的“听写+翻译+手调时间轴”组合拳。结果折腾了三天,才熬夜赶出了两个视频,不仅效率慢到让人崩溃,人工翻译和校对的成本换算下来更是高得吓人。
对于高频产出的短视频团队或跨境玩家来说,纯人工堆砌字幕完全是一个无底洞。我们需要的是能够快速吞噬海量视频资产的智能化流水线。
在市面上测试了十几款AI转写和翻译工具后,我们最终将团队的流水线固化在了 有道翻译 的视频翻译生态中。网易有道在处理中英互译时,凭借其多年积累的词典语料库,在断句逻辑、俚语本土化翻译、以及中英双行字幕排版上,都有着极其硬核的底层优势。
有道视频翻译自动生成双语字幕的底层技术骨架
很多人以为视频翻译就是把视频传上去,等进度条走完就完事了。作为技术栈负责人,我必须明确告诉你:不了解工具的底层逻辑,你就永远避不开“音画不同步”和“词不达意”的魔咒。
有道视频翻译自动生成中英双语字幕的背后,是由四个底层的AI引擎在并行运转:
[原始视频输入]
 │
 ▼
 1. 声音活动检测 (VAD) ───> 过滤噪音,切分音频切片
 │
 ▼
 2. 自动语音识别 (ASR) ───> 将英文/中文语音转化为原始文本
 │
 ▼
 3. 神经网络翻译 (NMT) ───> 双语上下文语境对齐与本地化润色
 │
 ▼
 4. 时间轴对齐算法 ───> 生成符合 W3C 标准的双语字幕流
 │
 ▼
[中英双语字幕视频 / SRT文件]
-
VAD(Voice Activity Detection,静音与声音边界检测):它负责扫描视频的音频轨道,把连续的声波切分成一句话一句话的“音频切片”。
-
ASR(Automatic Speech Recognition,语音识别引擎):采用类似于 OpenAI Whisper 架构 的端到端深度学习模型,把切分出来的声音转化成文本。
-
NMT(Neural Machine Translation,神经网络翻译):将识别出的源语言文本放到上下文语境中,进行语义理解并转化为目标语言(中英双语)。
-
时间轴对齐算法:根据音频的时间戳信息,自动将中文和英文精准拼合在同一个时间轴区间内,确保双行显示时不会发生上下行错位。
3步搭建有道视频翻译双语字幕流水线
准备好你的原始视频文件(推荐使用 MP4 或 MOV 格式,分辨率不限,但音频采样率最好在 44.1kHz 以上),跟着我一步步走。
第一步:音频预清洗与视频挂载
这里有一个绝大多数小白都会踩的深坑:直接上传带有巨大轰鸣声、风噪或重度BGM的视频。
如果你的视频背景音乐声音过大,有道的 VAD 引擎会被严重干扰,把完整的一句话切成碎片,导致翻译出来的中文前言不搭后语。
-
内行做法:在上传有道之前,先用剪辑软件(如 CapCut 或 Premiere Pro)执行一键“音频降噪”或“人声分离”。把干净的人声轨保留下来。
-
打开有道视频翻译工作台,将处理好的视频直接拖拽进上传区域。
第二步:核心翻译参数配置(防崩盘的关键)
视频上传后,系统会弹出一个参数配置窗口。这里的选项直接决定了你后续需要花多少时间进行人工修图。
| 配置项 | 核心策略与推荐参数 | 内行避坑解释 |
| 源语言 (Source Language) | 根据视频原声死锁(如 English) | 绝对不要选“自动识别”,自动识别在遇到中英夹杂的视频时极易发生语系判断疲劳。 |
| 目标语言 (Target Language) | 选择 中英双语 (Simplified Chinese & English) | 系统会自动采用双行排版样式。 |
| 术语库挂载 (Glossary) | 必须手动导入你的行业专属词表 | 比如跨境电商、数码评测的专业名词,如果不挂载,AI 会把“GPU”硬翻成“图形处理器”或发生乱翻。 |
| 单行最大字数限制 | 中文推荐 16-18字,英文推荐 35-40码 | 超过这个阈值,字幕在手机屏幕上就会挤成三行,严重遮挡视频画面。 |
第三步:AI工作台精修与时间轴微调
点击开始翻译后,有道的云端GPU集群会开始跑码。一个10分钟的视频通常在2-3分钟内就能完成转写。
跑完之后,不要直接导出,点击进入在线智能编辑器。你会看到左侧是实时预览画面,右侧是中英双语对照的时间轴切片。
-
检查断句点:如果发现英文句子太长,导致中文翻译挤成一大坨,直接把光标定位到文本中间,按下
Enter键。有道工作台会自动将该条时间轴平分为两段,并且重新触发 NMT 引擎对切分后的短句进行语法二次润色。 -
处理视频内嵌文本的冲突:有时候原视频画面里已经带有一些英文字幕或者花字特效,如果直接叠加双语字幕会显得极为混乱。这个时候,纯靠语音识别是不够的。如果你需要将视频画面中原本就存在的、无法通过声音识别的艺术字也翻译出来,建议配合 有道翻译识别艺术字的高阶OCR实操指南 进行背景文字层面的清理与重构,做到全方位的无死角视觉本土化。
完成所有微调后,点击右上角的导出。你可以选择直接导出“内嵌双语字幕的硬编码视频”,也可以单独导出符合 W3C WebVTT 标准 的 .srt 或 .vtt 外挂字幕文件,方便上传到 YouTube 或播放器中。
从离线视频翻译到跨国会议实时双语输出
在实际的企业运营中,我们不仅要面对已经录制好的离线视频,还经常会遭遇临时的跨国线上会议、海外直播、或者是大洋彼岸的实时视频连线培训。
如果你寄希望于把会议录像录下来再走上面这套“视频翻译”流程,那信息的时效性早就凉透了。
针对这种需要高频互动、现做现卖的视频音频场景,我们团队在日常工作流程中会直接无缝切换到有道的另一套衍生绝活——会议实时工作流。
在这种高动态场景下,系统不仅能够在你说话的同步瞬间、像流式传输(Streaming)一样在屏幕下方压制出中英双语字幕,还能在会议结束的瞬间,利用大语言模型(LLM)一键提炼出整场视频会议的核心纪要与行动项。老铁们如果日常有高频的远程涉外沟通需求,可以深度研读这篇关于 有道翻译会议模式深度解析 的进阶实操,把离线字幕的生成逻辑降维应用到实时协同中去。
常见问题解答 (FAQ)
Q1:为什么有道视频翻译生成的字幕会出现严重的音画不同步(时间轴漂移)?
A: 这种情况90%是因为原视频在录制或导出时采用了可变帧率(VFR, Variable Frame Rate)。AI 引擎在计算音频时间戳时是按照固定时钟周期(CFR)来跑的,帧率一变,时间轴就会像多米诺骨牌一样在中后期全盘崩溃。解决办法很简单:在上传视频前,先用小丸工具箱或者 HandBrake 软件,把视频强制转码为固定帧率(Constant Frame Rate,如 24fps 或 30fps),然后再丢给有道,保证稳如老狗。
Q2:自动生成的英文字幕太长,导致中文翻译直接被挤到屏幕外面去了怎么办?
A: 出现这个现象是因为你没有在初始化阶段限制“单行最大字符数(Max Characters Per Line)”。不要慌,不用重新翻译。直接进入有道的在线智能编辑器,找到那几行爆满的字幕,按快捷键 Ctrl + Enter 执行硬断句。系统会自动把这一行劈成上下两行,并在时间轴上进行合理的毫秒级平分,中文也会随之自动缩短排版。
Q3:有道视频翻译对专有名词(如医学、AI大模型领域的特定缩写)翻译不准怎么调校?
A: 机器翻译(NMT)是基于概率模型的,遇到冷门或最新的行业词汇确实容易抓瞎。最高效的解法是在翻译前,在工作台的“自定义术语库(Glossary)”中上传一个你的专属词表。格式很简单,左边英文,右边中文(例如:Prompt Engineering 提示词工程)。挂载之后,有道的 NMT 引擎在解码时会强制给这些词赋予最高权重的特定翻译,从源头上杜绝机翻硬伤。
S
有道翻译安全通讯编辑部
安全通讯软件技术与支持团队
安全通讯软件技术与支持团队
本文由有道翻译安全通讯编辑部撰写和审核。我们持续跟踪有道翻译软件更新,为您提供最新的安装教程、安全设置指南、隐私保护方案和问题解决方案。如有疑问,欢迎在评论区留言。
📌 本文内容基于有道翻译官方文档和实际测试编写,转载请注明出处。